
 Home
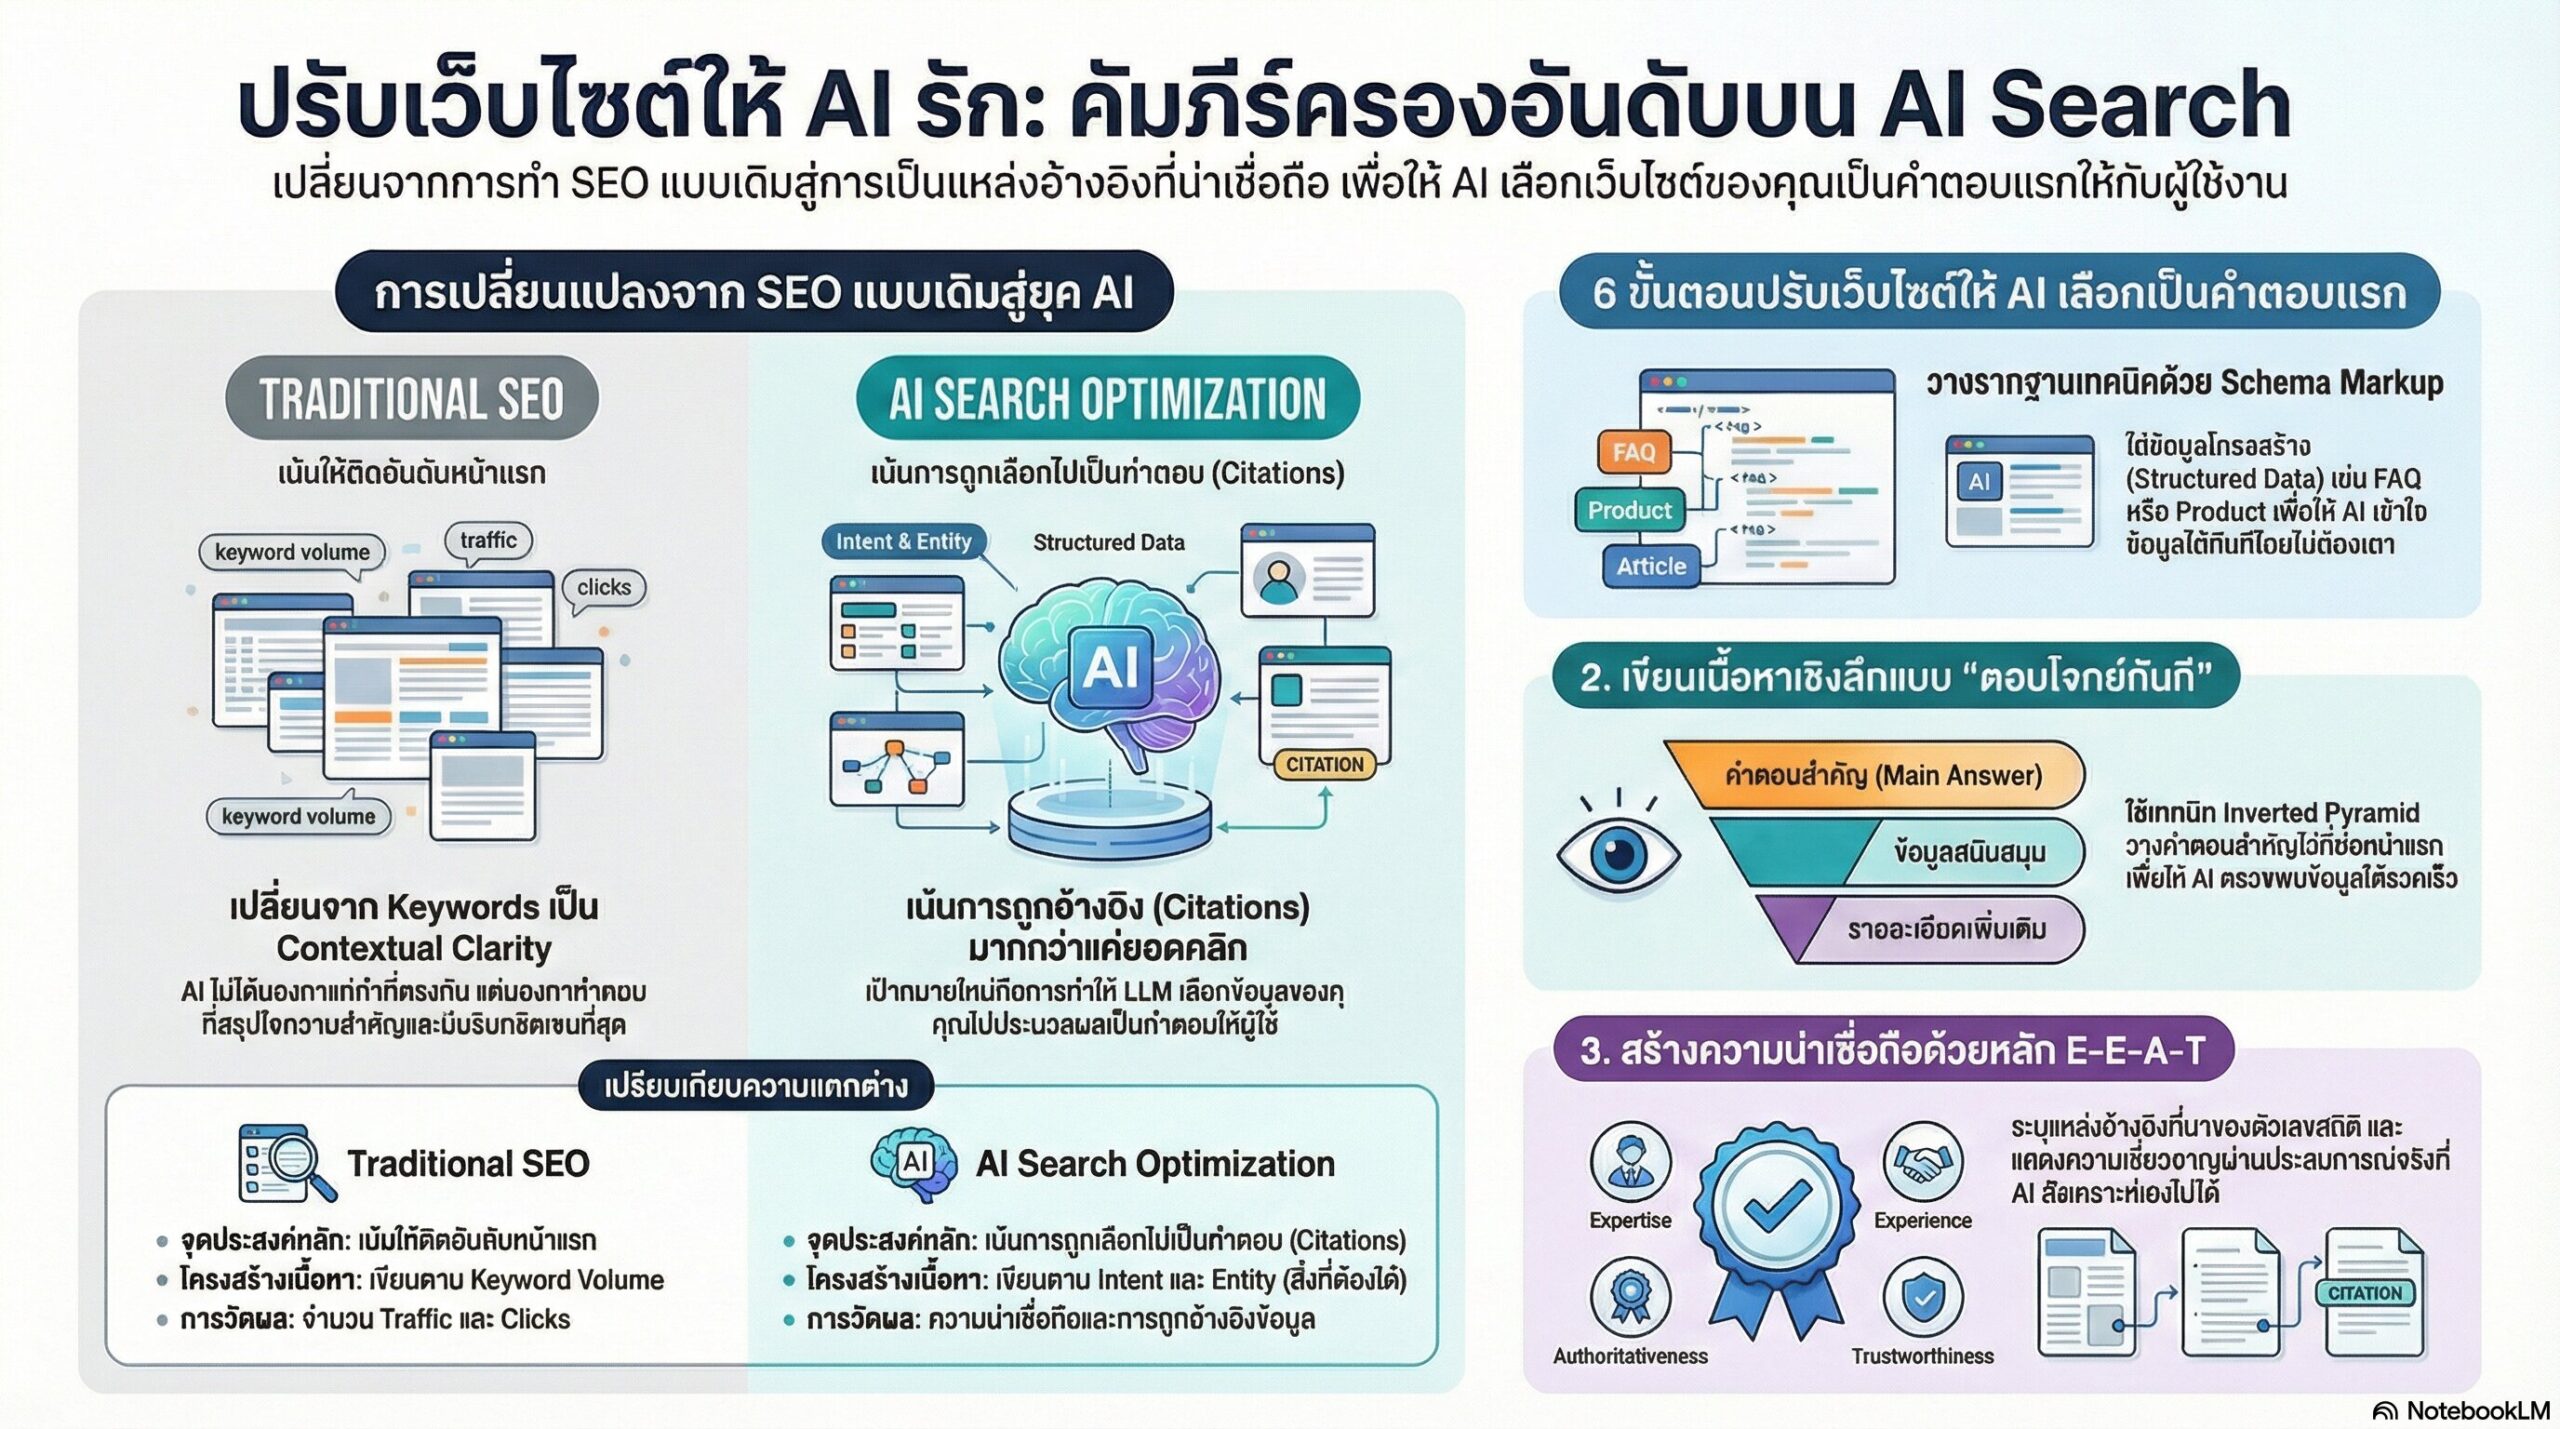
การค้นหาข้อมูลบนอินเทอร์เน็ตกำลังก้าวเข้าสู่ยุคของการใช้ปัญญาประดิษฐ์ประมวลผลคำตอบ หรือ AI Search อย่างเต็มตัว ผู้ใช้งานเริ่มเปลี่ยนพฤติกรรมจากการคลิกดูผลการค้นหาแบบ 10 ลิงก์สีน้ำเงิน (10 Blue Links) มาเป็นการอ่านบทสรุปคำตอบโดยตรงจาก Google AI Overviews, ChatGPT Search, และ Perplexity หากเว็บไซต์ของคุณยังคงโครงสร้างแบบเดิมที่เน้นเพียงการวางคีย์เวิร์ดโดยปราศจากความชัดเจนเชิงความหมาย (Semantic Clarity) ข้อมูลในเว็บอาจถูกบอทของ AI มองข้ามไปอย่างสิ้นเชิง
บทความนี้ได้สรุป เช็คลิสต์ 7 ขั้นตอนการเตรียมเว็บไซต์ให้พร้อมสำหรับ AI Search ครอบคลุมทั้งฝั่งเทคนิค (Technical Architecture) และโครงสร้างเนื้อหา (Content Structuring) พร้อมตารางเปรียบเทียบ ตัวอย่างโค้ด robots.txt, Schema Markup และไฟล์ llms.txt เพื่อให้เว็บไซต์ของคุณสามารถเป็นแหล่งข้อมูลอ้างอิงหลัก (Primary Citation Source) ให้แก่ระบบ AI ได้อย่างมีประสิทธิภาพ
สารบัญเนื้อหา (Table of Contents)
1. AI Search คืออะไร และทำไมพฤติกรรมการค้นหาจึงเปลี่ยนไป?
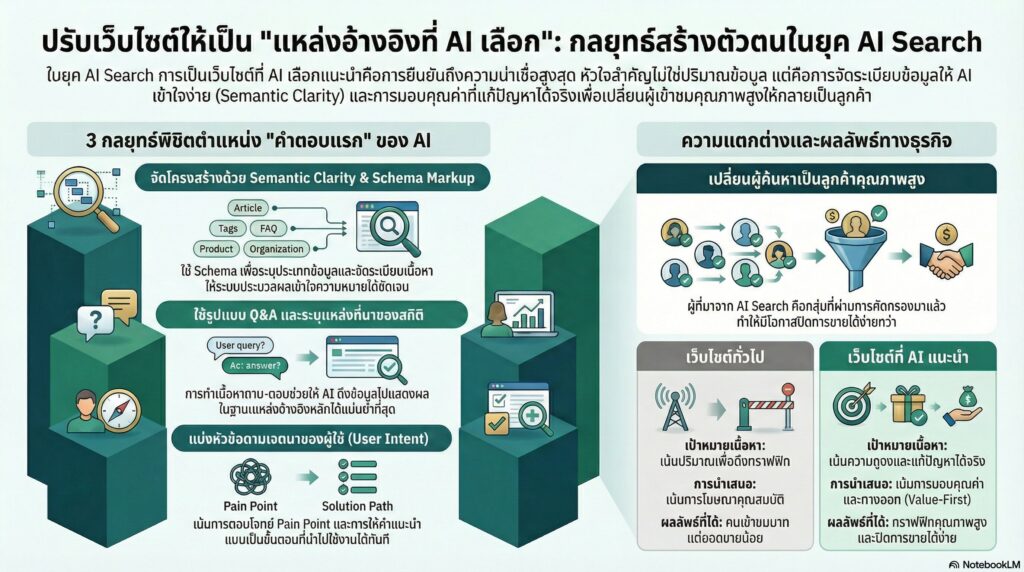
AI Search คือระบบการสืบค้นข้อมูลที่ขับเคลื่อนด้วยแบบจำลองภาษาขนาดใหญ่ (Large Language Models: LLM) ร่วมกับเทคโนโลยี RAG (Retrieval-Augmented Generation) ทำหน้าที่รวบรวมข้อมูลจากเว็บเพจหลายแห่งในแบบเรียลไทม์ นำมาประมวลผล สังเคราะห์ และสรุปเป็นคำตอบที่ตรงกับเจตนาของผู้ค้นหาในทันที แทนที่จะแสดงเพียงรายการลิงก์ให้ผู้ใช้ต้องคลิกเข้าไปอ่านทีละหน้าด้วยตนเอง
จาก 10 Blue Links สู่คำตอบแบบสรุปทันที (Generative Summaries)
ในการค้นหาแบบดั้งเดิม ผู้ใช้งานต้องกรอกคีย์เวิร์ดสั้นๆ เช่น “วิธีคำนวณภาษี 2569” แล้วเปิดหน้าเว็บ 3-4 ลิงก์เพื่อรวบรวมข้อมูล แต่ในระบบ AI Search ผู้ใช้จะตั้งคำถามเชิงสนทนาที่ซับซ้อน เช่น “เปรียบเทียบการลดหย่อนภาษีระหว่างกองทุน ThaiESG กับ RMF ในปี 2569 พร้อมสรุปเงื่อนไขและเพดานสิทธิ์” ระบบ AI จะอ่านและวิเคราะห์หน้าเว็บที่เกี่ยวข้อง จากนั้นสร้างบทสรุปที่ตอบคำถามนั้นทันที พร้อมแนบลิงก์อ้างอิง (Citations) ชี้ไปยังแหล่งข้อมูลต้นทาง
ตารางเปรียบเทียบ: Traditional SEO vs. AI Search Optimization (GEO/AEO)
การปรับแต่งเว็บไซต์ในปัจจุบันจึงต้องปรับมุมมองจากการทำ SEO แบบเดิม สู่การปรับให้รองรับระบบดึงข้อมูลของ AI ควบคู่กันไป ดังนี้
| มิติการทำงาน | Traditional SEO (ดั้งเดิม) | AI Search Optimization (GEO / AEO) |
|---|---|---|
| เป้าหมายสูงสุด | ติดอันดับ 1-10 บนหน้าแสดงผล Google SERP | ถูกเลือกเป็นแหล่งข้อมูลอ้างอิงหลัก (Primary Citation Source) |
| กลไกการคัดเลือก | PageRank, Keyword Match, Backlinks ปริมาณมาก | ความชัดเจนเชิงความหมาย (Semantic Clarity), Entity, Information Gain |
| พฤติกรรมผู้ใช้ | สแกน Title & Meta Description แล้วคลิกเข้าเว็บ | อ่านคำตอบสรุป และคลิกลิงก์อ้างอิงเมื่อต้องการศึกษาข้อมูลเชิงลึก |
| โครงสร้างข้อมูล | จัดวางคีย์เวิร์ดใน Title, H1, Body Text | Semantic HTML, ตารางเปรียบเทียบ, FAQ, Schema.org JSON-LD |
| ตัวชี้วัดความสำเร็จ | Organic Keyword Rankings, Clicks, Impressions | AI Mentions, Brand Citations, Referral Traffic คุณภาพสูง |
กลไก RAG และการทำงานของ AI Crawler
ระบบ AI Search ไม่ได้แต่งเรื่องขึ้นเองตามความทรงจำในโมเดล แต่ใช้ขั้นตอน Retrieval (การดึงข้อมูลสด) โดยส่งเว็บครอว์เลอร์ (Web Crawler) เช่น GPTBot, ClaudeBot, หรือ PerplexityBot เข้าไปเก็บข้อมูลจากหน้าเว็บที่เกี่ยวข้อง นำเนื้อหามาแปลงเป็น Vector Embeddings เพื่อคำนวณหาความใกล้เคียงกับคำถามของผู้ใช้ ก่อนจะส่งเนื้อหาท่อนที่ตรงประเด็นที่สุดเข้าสู่กระบวนการ Generation (การสังเคราะห์คำตอบ) ของ LLM ต่อไป
2. อุปสรรคทางเทคนิคที่ทำให้ AI Search มองข้ามเว็บไซต์
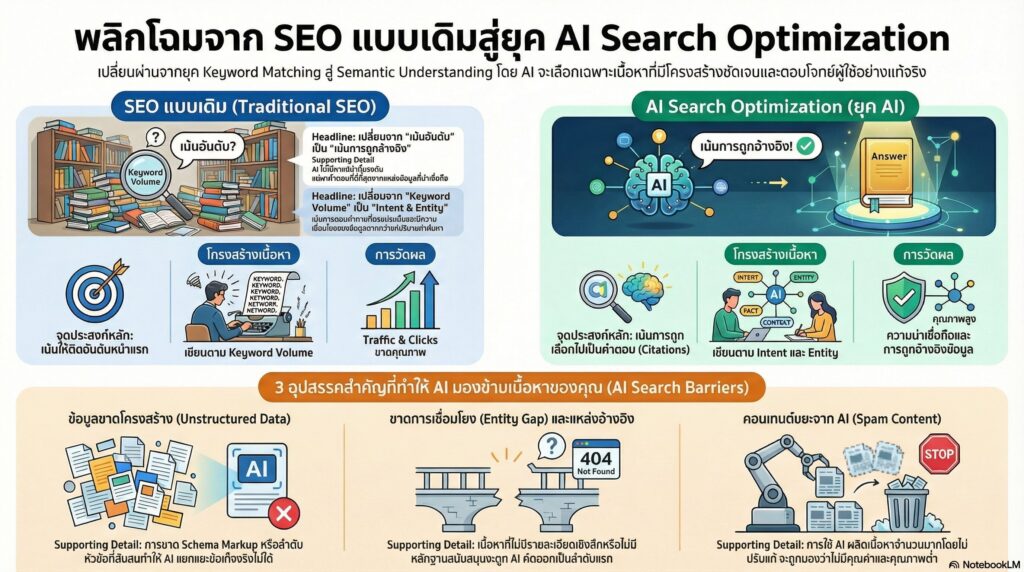
หลายเว็บไซต์มีเนื้อหาที่มีคุณค่าสูง แต่กลับไม่เคยปรากฏในผลสรุปของ AI Overviews หรือ ChatGPT สาเหตุส่วนใหญ่ไม่ได้เกิดจากคุณภาพเนื้อหา แต่เกิดจาก ข้อจำกัดทางเทคนิคและสถาปัตยกรรมเว็บไซต์ ที่เป็นอุปสรรคต่อการประมวลผลของบอท:
1. การบล็อก AI Bot ใน robots.txt โดยไม่รู้ตัว
มีเว็บไซต์จำนวนมากที่คัดลอกไฟล์ robots.txt มาตรฐาน หรือใช้ปลั๊กอินความปลอดภัยที่ตั้งค่าบล็อก User-Agent แปลกหน้า ทำให้บอทของ AI อย่าง GPTBot, PerplexityBot, ClaudeBot หรือ Google-Extended ไม่สามารถเข้าไปอ่านเนื้อหาเพื่อนำไปประมวลผลในระบบค้นหาได้
2. เว็บไซต์แสดงผลด้วย Client-Side Rendering (CSR) ล้วน
แม้ว่าเครื่องมือค้นหาหลักจะประมวลผล JavaScript ได้ในระดับหนึ่ง แต่สำหรับ AI Search Crawlers ที่ต้องประมวลผลข้อมูลอย่างรวดเร็วและประหยัดทรัพยากร หน้าเว็บที่ต้องรันสคริปต์ JavaScript หนักๆ เพื่อดึงเนื้อหามาแสดง (Client-Side Rendering) มักจะถูกบอทอ่านได้เพียงหน้าว่างเปล่า ส่งผลให้ข้อมูลถูกตัดทิ้งจากขั้นตอน Retrieval
3. เนื้อหาขาดความชัดเจนเชิงโครงสร้าง (Unstructured Data)
การเขียนเนื้อหาเป็นก้อนย่อหน้ายาวๆ โดยไม่มีหัวข้อย่อย (H2, H3), ขาดตารางเปรียบเทียบ, และไม่มี Schema Markup กำกับ จะทำให้โมเดลภาษาต้องใช้ต้นทุนในการคำนวณ (Compute Cost) สูงในการแยกแยะว่าข้อความใดคือข้อเท็จจริง ข้อใดคือความคิดเห็น หรือข้อใดคือคำตอบของคำถาม
3. เช็คลิสต์ 7 ขั้นตอนเตรียมเว็บไซต์ให้พร้อมสำหรับ AI Search (Actionable Checklist)
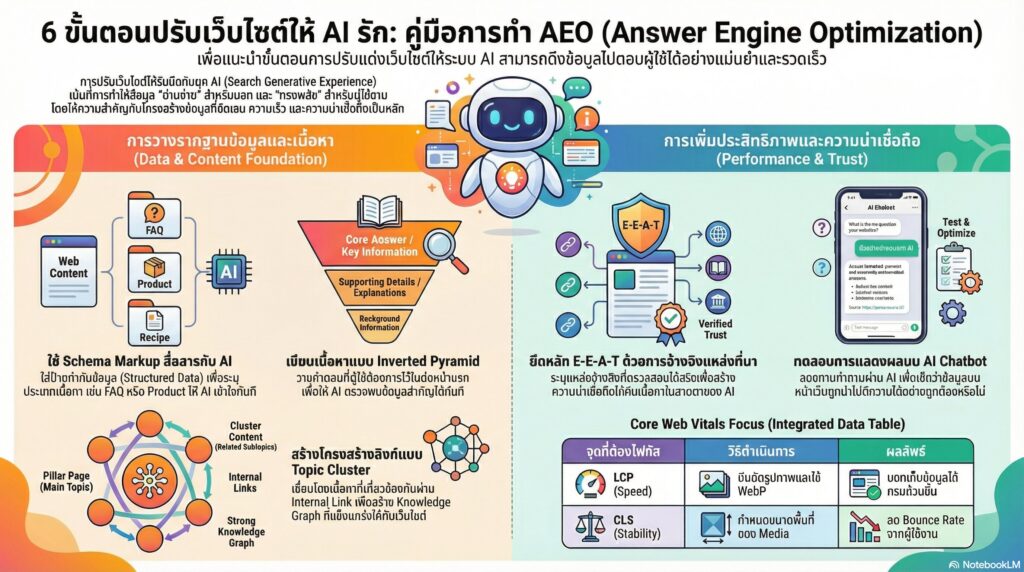
เพื่อให้เว็บไซต์ของคุณพร้อมรับการดึงข้อมูลของ AI Search ในทุกแพลตฟอร์มอย่างเป็นระบบ ให้ตรวจสอบและดำเนินการตามเช็คลิสต์ 7 ขั้นตอนนี้:
ขั้นที่ 1: ตรวจสอบและเปิดสิทธิ์การเข้าถึงใน robots.txt ให้กับ AI Search Bot
ข้อปฏิบัติ: แยกความแตกต่างระหว่าง “บอทสำหรับเทรนโมเดล AI” กับ “บอทสำหรับระบบค้นหา (Live Search Bot)” หากคุณต้องการให้เว็บไซต์ถูกอ้างอิงในผลค้นหา ต้องอนุญาตให้บอทค้นหาเข้าถึงได้ โดยระบุคำสั่งในไฟล์ robots.txt ดังนี้:
# อนุญาตให้ AI Search Crawlers เข้าถึงเนื้อหาเพื่อแสดงผลในระบบค้นหา
User-agent: GPTBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: Google-Extended
Allow: /

# สำหรับหน้าเนื้อหาทั่วไป ให้เปิด Sitemap ไว้อย่างชัดเจน
Sitemap: https://warrior.in.th/sitemap_index.xml
ขั้นที่ 2: วางโครงสร้างเนื้อหาแบบ Direct Answer Protocol (Inverted Pyramid)
ข้อปฏิบัติ: ในทุกหัวข้อย่อยที่เป็นคำถามหรือหัวข้อสำคัญ ให้เขียนสรุปคำตอบที่ชัดเจนและสมบูรณ์ในตัวเองขนาด 40-60 คำ ไว้ในย่อหน้าแรกทันที (Direct Answer) ตามด้วยข้อมูลขยายความ รายละเอียดเชิงเทคนิค หรือสถิติสนับสนุน การวางคำตอบไว้บนสุดจะช่วยให้อัลกอริทึมของ Google AI Overviews สกัดข้อมูล (Information Extraction) ไปเป็นคำตอบได้ทันทีโดยไม่ต้องอ่านทั้งหน้า
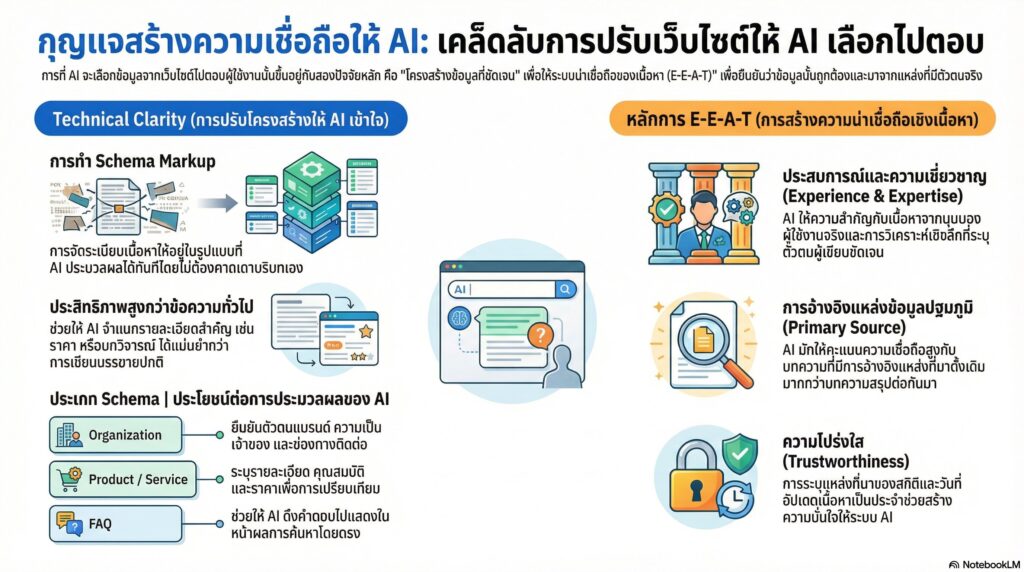
ขั้นที่ 3: ฝัง Schema.org JSON-LD เชื่อมโยง Knowledge Graph ครบวงจร
ข้อปฏิบัติ: ติดตั้งโครงสร้างข้อมูลความหมายผ่าน JSON-LD เพื่อให้บอทเข้าใจเอนทิตี (Entity) ของธุรกิจอย่างแจ่มแจ้ง โดยควรมี Schema พื้นฐานดังนี้:
Organization/LocalBusiness: ระบุชื่อแบรนด์, โลโก้, บริการ, และเชื่อมโยงsameAsไปยังช่องทางทางการและฐานข้อมูล (Wikidata, Social Profiles)ArticleหรือTechArticle: ระบุชื่อผู้เขียน (Author), องค์กรผู้เผยแพร่ (Publisher), วันที่เผยแพร่ และวันที่อัปเดตล่าสุด (dateModified)FAQPage: ระบุคู่คำถาม-คำตอบที่มีประโยชน์ ช่วยให้ AI Search หยิบไปแสดงผลแบบ Rich Results ได้ง่ายขึ้นProduct/Service: ระบุรายละเอียดคุณสมบัติ ราคา และข้อกำหนด เพื่อให้ AI แนะนำได้อย่างถูกต้อง
ขั้นที่ 4: จัดระเบียบข้อมูลด้วยตาราง (HTML Table) และ Bullet Points
ข้อปฏิบัติ: โมเดลภาษาประมวลผลข้อมูลที่มีโครงสร้างเป็นแถวและคอลัมน์ได้แม่นยำกว่าข้อความร้อยแก้วยาวๆ หากในเนื้อหามีการเปรียบเทียบ, สรุปสเปกสินค้า, หรือขั้นตอนการดำเนินงาน ให้จัดทำเป็น <table> ที่มี <th> ระบุหัวตารางชัดเจน ข้อมูลในรูปแบบตารางมีโอกาสถูกนำไปสร้างเป็นคำตอบแบบตารางบน AI Overviews สูงกว่าเนื้อหาทั่วไปอย่างมีนัยสำคัญ
ขั้นที่ 5: จัดทำไฟล์ llms.txt และสถาปัตยกรรมข้อมูลสำหรับ AI Agents
ข้อปฏิบัติ: มาตรฐาน llms.txt (วางไว้ที่ yourdomain.com/llms.txt) คือรูปแบบใหม่ที่ออกแบบมาเพื่อให้โมเดลภาษาขนาดใหญ่เข้าใจสาระสำคัญของเว็บไซต์ได้ในไฟล์เดียว โดยรวบรวมรายการลิงก์หน้าสำคัญ สรุปบริการหลักขององค์กร และคำแนะนำเนื้อหาในรูปแบบ Markdown ที่กระชับและไม่มีโค้ด HTML รบกวน
ขั้นที่ 6: สร้างสัญญาณ E-E-A-T และการอ้างอิงข้อมูลปฐมภูมิ (Primary Sources)
ข้อปฏิบัติ: ตามแนวทางของระบบประเมินคุณภาพ Google Helpful Content และสิทธิบัตรการจัดทำบทสรุปของ AI ระบบจะให้คะแนนความน่าเชื่อถือกับเนื้อหาที่มีหลักฐานชัดเจน:
- ระบุประวัติผู้เชี่ยวชาญ (Author Box) พร้อมผลงานและประสบการณ์จริงในสายงาน
- อ้างอิงแหล่งข้อมูลปฐมภูมิ เช่น เอกสารสิทธิบัตร งานวิจัยทางวิชาการ หรือสถิติที่ตรวจสอบที่มาได้
- เพิ่มมุมมองเชิงลึก (Information Gain) เช่น ภาพถ่ายการทำงานจริง ข้อมูลตัวเลขจากการทดลอง หรือแนวคิดที่ไม่สามารถคัดลอกได้ทั่วไป
ขั้นที่ 7: วางสถาปัตยกรรมลิงก์ภายในตาม Topic Clusters (Internal Linking Architecture)
ข้อปฏิบัติ: สร้างเครือข่ายความรู้เฉพาะด้าน (Topical Authority) โดยเชื่อมโยงหน้าเสาหลัก (Pillar Page) เข้ากับบทความสนับสนุน (Cluster Content) ด้วย Anchor Text ที่ระบุความหมายชัดเจน ช่วยให้ AI Search เข้าใจว่าเว็บไซต์ของคุณมีความลึกซึ้งในกลุ่มประเด็นนั้นอย่างครบถ้วน ไม่ใช่เพียงบทความเดี่ยวที่สร้างขึ้นมาลอยๆ
4. วิธีทดสอบและวัดผลความพร้อมของเว็บไซต์บน AI Search
หลังจากปรับแต่งตามเช็คลิสต์แล้ว เจ้าของเว็บไซต์และทีมการตลาดควรดำเนินการตรวจสอบความพร้อมด้วยขั้นตอนต่อไปนี้:
1. ตรวจสอบสถานะการเก็บข้อมูลของ Bot (Server Access Logs)
ตรวจสอบบันทึกเซิร์ฟเวอร์ (Server Logs) เพื่อดูว่ามีคำขอ (Request) จาก User-Agent ของ GPTBot, PerplexityBot หรือ ClaudeBot เข้ามาเก็บข้อมูลและได้รับสถานะ HTTP 200 OK หรือไม่ หากพบรหัสสถานะ 403 Forbidden หรือ 429 Too Many Requests ให้ปรับค่าความถี่หรือตรวจสอบไฟร์วอลล์ (Cloudflare WAF / Security Rules) ทันที
2. ทดสอบ Prompt Testing บน AI Search Engines โดยตรง
ป้อนคำถามที่เกี่ยวข้องกับธุรกิจ สินค้า หรือบริการของคุณบน ChatGPT Search, Perplexity และ Google AI Overviews สังเกตว่า:
- แบรนด์ของคุณถูกเอ่ยถึง (Brand Mention) ในคำตอบหรือไม่?
- ลิงก์จากเว็บไซต์ของคุณถูกแนบเป็นแหล่งอ้างอิง (Citation Source) หรือไม่?
- ข้อมูลสรุปที่ AI นำเสนอถูกต้องตรงกับข้อเท็จจริงบนหน้าเว็บหรือไม่?
3. ติดตาม Referral Traffic จากแหล่ง AI ใน Google Analytics 4 (GA4)
สร้างการตั้งค่าคัดกรองทราฟฟิกใน GA4 โดยมอนิเตอร์ Traffic Source จากโดเมน AI เช่น chatgpt.com, android-app://com.openai.chatgpt, perplexity.ai, และ claude.ai เพื่อวัดผลอัตราการแปลงเป็นลูกค้า (Conversion Rate) ที่เกิดขึ้นจากช่องทางนี้
5. คำถามที่พบบ่อยเกี่ยวกับการเตรียมเว็บไซต์สำหรับ AI Search (FAQ)
1. การปรับเว็บไซต์ให้รองรับ AI Search จะส่งผลเสียต่อคะแนน SEO ปกติบน Google หรือไม่?
ไม่ส่งผลเสีย แต่กลับส่งเสริมคะแนน SEO โดยตรง เนื่องจากเกณฑ์ที่ AI Search ใช้คัดเลือกข้อมูล เช่น การมีโครงสร้าง Semantic HTML ชัดเจน, การมี Schema Markup, การเขียนคำตอบตรงประเด็น (Direct Answer), และการปฏิบัติตามหลัก E-E-A-T ล้วนเป็นเกณฑ์เดียวกันกับที่ Google ใช้ประเมินคุณภาพในระบบ Helpful Content System ดังนั้นเว็บไซต์ที่พร้อมสำหรับ AI Search จึงมักมีอันดับบนหน้าค้นหาปกติที่ดีขึ้นไปด้วย
2. หากต้องการให้เว็บไซต์ปรากฏในคำตอบของ ChatGPT Search และ Perplexity ต้องเปิดบอทตัวใดบ้าง?
ต้องเปิดอนุญาต User-Agent อย่างน้อย 3 บอทหลักใน robots.txt ได้แก่ GPTBot (สำหรับ OpenAI / ChatGPT Search), PerplexityBot (สำหรับ Perplexity AI), และ ClaudeBot (สำหรับ Anthropic) หากเป็นบอทของ Google เช่น Google-Extended ก็ควรเปิดไว้หากต้องการให้ข้อมูลถูกนำไปสังเคราะห์ใน Google AI Overviews และ Gemini
3. ไฟล์ llms.txt คืออะไร และมีความจำเป็นต่อทุกเว็บไซต์หรือไม่?
llms.txt คือไฟล์ข้อความมาตรฐาน (Markdown) ที่จัดระเบียบสาระสำคัญของเว็บไซต์เพื่อให้ AI อ่านได้ง่ายและประหยัด Token แม้ปัจจุบันยังไม่ใช่ข้อบังคับทางเทคนิคที่เคร่งครัดเหมือน robots.txt แต่การมีไฟล์ llms.txt จะช่วยอำนวยความสะดวกอย่างมากให้กับ AI Coding Assistants, Agentic AI, และ LLM Crawlers ในการเข้าใจขอบเขตธุรกิจและเข้าถึงเนื้อหาสำคัญได้อย่างรวดเร็ว
4. เว็บไซต์ธุรกิจ SME หรือเว็บไซต์ใหม่ มีโอกาสถูก AI Search อ้างอิงเทียบเท่าแบรนด์ใหญ่หรือไม่?
มีโอกาสอย่างแน่นอน เพราะ AI Search ตัดสินการดึงข้อมูลจาก “ความตรงประเด็นของคำตอบและความสดใหม่ของข้อมูลเฉพาะทาง” (Context Relevance & Information Gain) มากกว่าการดูปริมาณ Backlink เพียงอย่างเดียว หากเว็บไซต์ธุรกิจขนาดเล็กเขียนบทความตอบโจทย์เชิงลึก มีตารางเปรียบเทียบราคาหรือขั้นตอนที่ชัดเจน และมี Schema Markup บอทของ AI ก็พร้อมจะหยิบข้อมูลนั้นไปเป็นคำตอบหลักได้ทันที
6. สรุปแนวทางปฏิบัติและก้าวต่อไปสำหรับเจ้าของเว็บไซต์
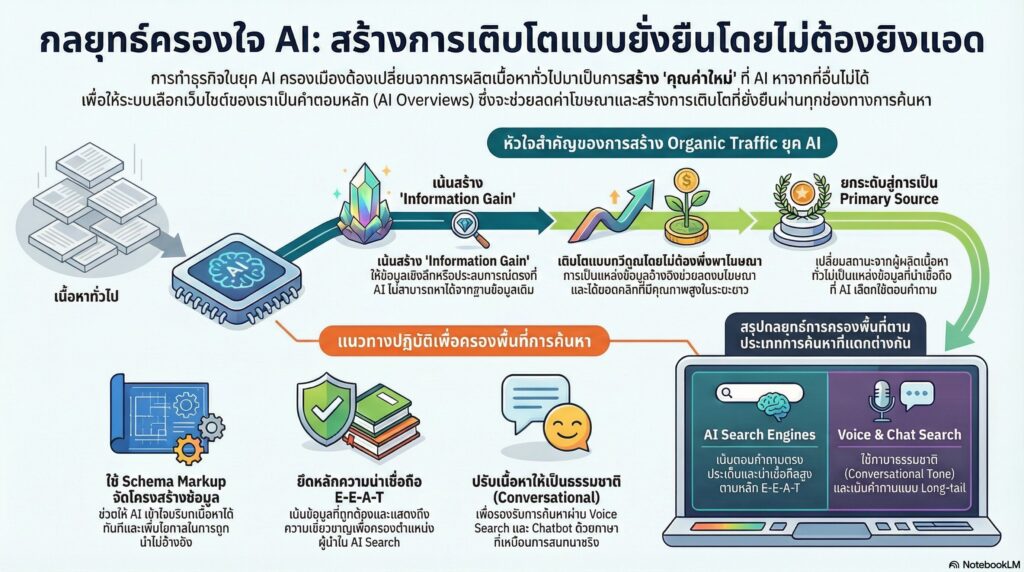
การเตรียมเว็บไซต์ให้พร้อมสำหรับ AI Search ไม่ใช่การละทิ้งหลักการ SEO แบบดั้งเดิม แต่คือการยกระดับคุณภาพข้อมูลจากระดับ “คำค้นหา” สู่ระดับ “ความหมายและโครงสร้างความรู้” (Semantic & Knowledge Engineering) โดยเริ่มจากการเคลียร์ช่องทางการเข้าถึงของบอทใน robots.txt, จัดระเบียบเนื้อหาให้อ่านง่ายแบบ Inverted Pyramid, และเสริมความแข็งแกร่งด้วย Schema.org JSON-LD
หากธุรกิจของคุณต้องการวางรากฐานการเติบโตในยุคการค้นหาด้วย AI สามารถศึกษาแนวทางและปรึกษาทีมงานผ่าน บริการที่ปรึกษา SEO และ บริการที่ปรึกษา AI Search & GEO ของ Warrior เพื่อยกระดับสถาปัตยกรรมเว็บไซต์ให้ก้าวล้ำหน้าคู่แข่งในทุกมิติของการค้นหา
