
 Home
ในยุคแรกเริ่มของเสิร์ชเอ็นจิน การจัดทำดัชนีเว็บไซต์ (Indexing) อิงอยู่กับโมเดล Inverted Index แบบคำเดี่ยว (Single-Word Tokenization) และการคำนวณความถี่ของคำผ่าน TF-IDF ซึ่งเปิดช่องโหว่ให้นักทำเว็บสายเทาใช้เทคนิคปั่นคีย์เวิร์ด (Keyword Stuffing) เพื่อดันอันดับได้อย่างง่ายดาย แต่จุดเปลี่ยนครั้งประวัติศาสตร์ของ Google เริ่มต้นขึ้นเมื่อมีการจดสิทธิบัตร US 7,536,408 B2 ในชื่อ “Phrase-based indexing in an information retrieval system” โดยทีมนักวิทยาศาสตร์ข้อมูล นำโดย Anna L. Patterson
สิทธิบัตรฉบับนี้คือรากฐานสำคัญที่ปฏิวัติวงการ SEO สู่ยุค Topical Authority, Semantic SEO และส่งอิทธิพลโดยตรงมาถึงระบบ AI Overviews (AEO) และ Generative Engine Optimization (GEO) ในปัจจุบัน หากธุรกิจของคุณต้องการติดอันดับเสิร์ชอย่างยั่งยืน การทำความเข้าใจกลไก Phrase-Based Indexing จึงเป็นสิ่งที่ไม่อาจมองข้าม
1. ทำความรู้จัก Phrase-Based Indexing: จุดเปลี่ยนจากระบบคำเดี่ยวสู่กลุ่มวลีเชิงความหมาย
สรุปคำตอบโดยตรง (Direct Answer): Phrase-Based Indexing คือสถาปัตยกรรมการจัดทำดัชนีของ Google ที่ก้าวข้ามการมองคำเดี่ยว (Single Words) ไปสู่การวิเคราะห์ “กลุ่มวลีที่ปรากฏร่วมกันอย่างมีความหมาย” (Co-occurring Phrases) ระบบจะประเมินบริบท ความลึกซึ้ง และอำนาจความรู้เชิงลึกของเนื้อหา ช่วยแยกบทความผู้เชี่ยวชาญตัวจริงออกจากเว็บสแปมได้อย่างแม่นยำ
ในอดีต หากหน้าเว็บมีคำว่า “ประกันภัยรถยนต์” ปรากฏอยู่ 20 ครั้ง ระบบค้นหาจะมองว่าหน้านั้นเกี่ยวข้องกับประกันภัยรถยนต์มากกว่าหน้าที่มีเพียง 5 ครั้ง แต่สิทธิบัตร Phrase-Based Indexing เปลี่ยนกติกานี้โดยสิ้นเชิง โดย Google ได้กำหนดหลักการว่า เอกสารที่มีคุณภาพสูงและเป็นแหล่งอ้างอิงจริง จะต้องมีกลุ่มคำที่สัมพันธ์กันในเชิงตรรกะ (Topical Semantics) ปรากฏร่วมอยู่ด้วยเสมอ
ตัวอย่างเช่น หากบทความพูดถึง “ประกันภัยรถยนต์ชั้น 1” เอกสารที่ดีควรมีวลีแวดล้อม เช่น “เบี้ยประกัน”, “ทุนประกันภัย”, “ความรับผิดต่อบุคคลภายนอก”, “ค่าเสียหายส่วนแรก (Deductible)”, และ “เคลมสด” ปรากฏร่วมกันในอัตราส่วนที่เหมาะสม หากหน้าเว็บใดมีแต่คำว่า “ประกันภัยรถยนต์” ซ้ำๆ แต่ไม่มีวลีเชิงความหมายเหล่านี้ ระบบจะลดทอนความน่าเชื่อถือลงทันที
2. สิทธิบัตร Google US 7,536,408 B2 ถอดรหัส 4 เฟสการประมวลผลดัชนี
สรุปขั้นตอนอัลกอริทึม: สิทธิบัตร US 7,536,408 B2 แบ่งการทำงานออกเป็น 4 เฟสหลัก ได้แก่ (1) การคัดเลือกวลีผู้สมัคร (Candidate Phrases) จากคลังเอกสาร (2) การจับคู่หาความสัมพันธ์ร่วม (Related Phrases) (3) การคำนวณคะแนน Information Gain (I) เพื่อตัดคำบังเอิญทิ้ง และ (4) การลงทะเบียนจัดทำ Posting Lists ดัชนีกลุ่มวลีความรู้
A[“1. คัดกรองวลีผู้สมัครจากเอกสาร
(Identifying Candidate Phrases)”] –> B[“2. จับคู่และค้นหากลุ่มวลีเกี่ยวเนื่อง
(Identifying Related Phrases)”] B –> C[“3. คำนวณค่าอัตราความสัมพันธ์ข้อมูล
(Information Gain ‘I’ Calculation)”] C –> D[“4. บันทึกดัชนีเชิงเครือข่ายส่งต่ออำนาจความรู้
(Topical Indexing into Posting Lists)”]
เฟสที่ 1: การคัดเลือกวลีผู้สมัคร (Identifying Candidate Phrases)
ระบบเริ่มสแกนฐานข้อมูลเอกสาร (Document Database) โดยตัดคำเชื่อมทั่วไป (Stopwords) และมองหากลุ่มคำประสม (N-grams) ที่มีความยาวตั้งแต่ 1 ถึงหลายคำ จากนั้นระบบจะสร้างเป็นทะเบียนคำผู้สมัคร (Candidate Phrases) เพื่อเตรียมเข้าสู่ขั้นตอนประเมินความสำคัญ
เฟสที่ 2: การค้นหาและจับคู่กลุ่มวลีเกี่ยวเนื่อง (Identifying Related Phrases)
Google จะตรวจสอบว่าในเอกสารที่พบวลีหนึ่ง มักจะพบวลีใดควบคู่กันเสมอในคลังเอกสารเว็บทั้งหมด เช่น เมื่อพบคำว่า “Machine Learning” มักพบคำว่า “Neural Networks”, “Gradient Descent”, และ “Training Dataset” ควบคู่กันเสมอ
เฟสที่ 3: การคำนวณคะแนน Information Gain (I)
หัวใจสำคัญที่สุดในสมการสิทธิบัตรข้อนี้คือการคำนวณ Information Gain ‘I’ โดยนำค่าการปรากฏร่วมกันจริงของคู่กลุ่มวลี A(j, k) มาเปรียบเทียบกับค่าความน่าจะเป็นที่คำทั้งสองจะปรากฏร่วมกันโดยบังเอิญ E(j, k):
I(j, k) = A(j, k) / E(j, k)
หากอัตราส่วน I(j, k) สูงกว่าค่าเกณฑ์มาตรฐาน (Threshold) ระบบจะจัดว่าวลีทั้งสองเป็น “Related Phrases” ที่มีความสัมพันธ์เชิงเนื้อหาแน่นแฟ้น แต่หากค่าต่ำกว่าเกณฑ์ ระบบจะมองว่าเป็นเพียงความบังเอิญและไม่นำมานับเป็นค่าคะแนนความเชี่ยวชาญ
เฟสที่ 4: การจัดทำสารบัญดัชนีกลุ่มวลี (Topical Posting Lists)
เมื่อได้คู่คำที่ผ่านเกณฑ์ ระบบจะบันทึกหน้าเว็บลงใน Posting List ของกลุ่มวลีนั้นๆ ซึ่งต่างจาก Inverted Index แบบเดิม เพราะ Posting List นี้เชื่อมโยงอำนาจความรู้ของกลุ่มวลีเข้าหากัน ทำให้หน้าเว็บสามารถจัดอันดับบนคีย์เวิร์ดที่เกี่ยวข้องได้ แม้ในหน้าเว็บนั้นจะไม่ได้ใส่คีย์เวิร์ดดังกล่าวลงไปตรงๆ ก็ตาม
🔎 เครื่องมือส่องแบบผังวิศวกรรมสิทธิบัตรจริง (USPTO Patent Blueprints)
คลิกที่แต่ละแท็บเพื่อสำรวจแบบร่างทางเทคนิคดั้งเดิมจากคำขอจดสิทธิบัตรของ Google (US 7,536,408 B2)
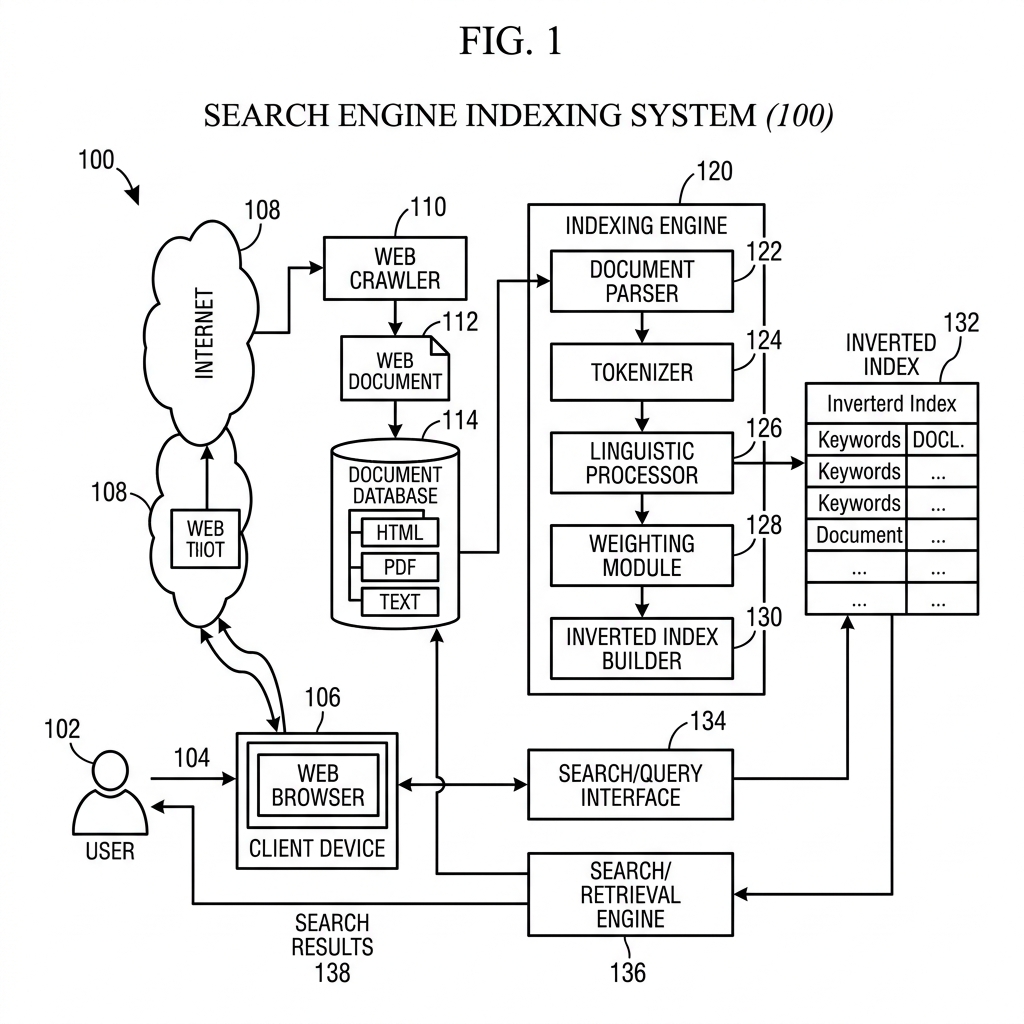
แสดงโครงสร้างการติดต่อระหว่างผู้ใช้ (Client 102) และระบบค้นหาของ Google (Search System 104) ซึ่งแบ่งระบบจัดทำดัชนี (Indexing System 106) ออกมาเป็นส่วนแยก เพื่อทำหน้าที่สแกนเอกสารใน Document Database (108) และแปลงเป็นโครงสร้างแบบวลีร่วม ก่อนจัดส่งเข้าดัชนีค้นหาหลัก
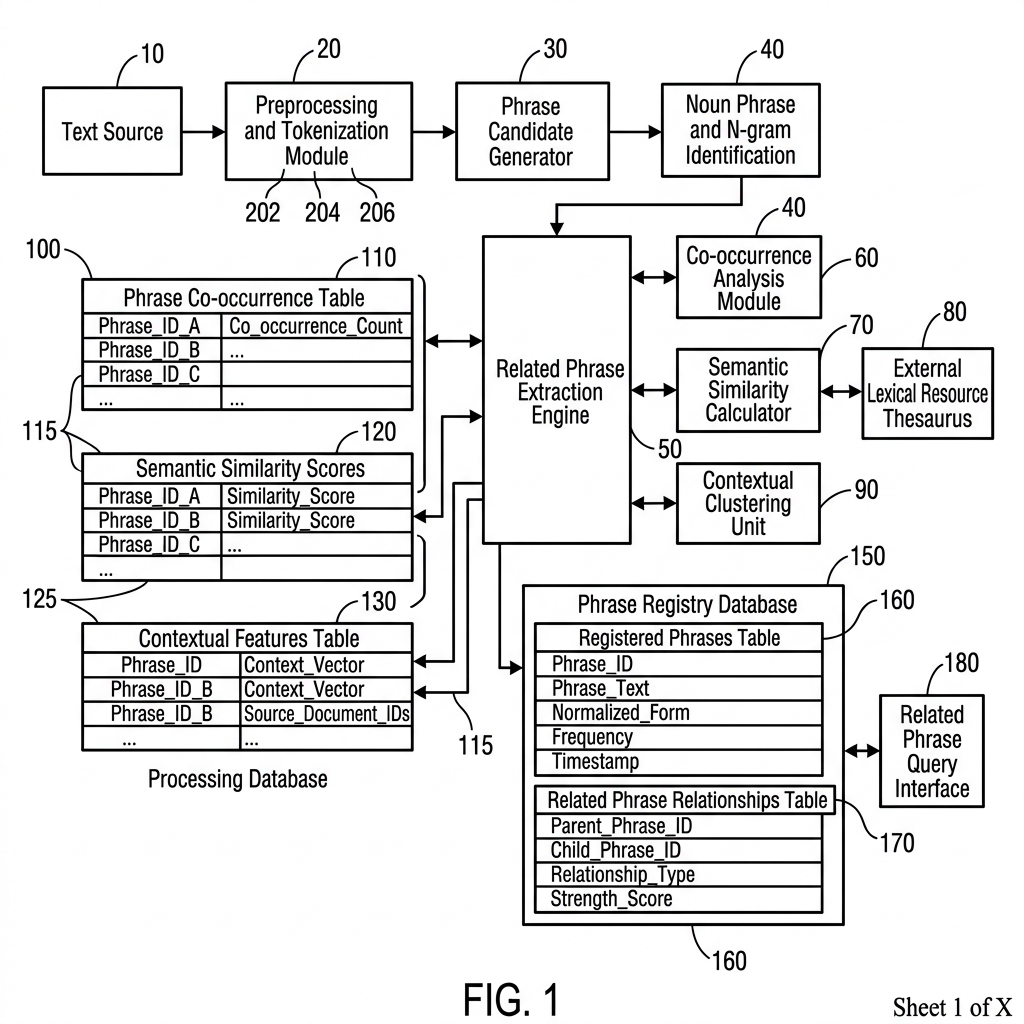
แสดงส่วนประกอบการสแกนบทความเพื่อจำแนกวลีหลัก (Phrase Identifier 202) และการตรวจสอบความสัมพันธ์ผ่านคลังจดทะเบียนวลีกลาง (Phrase Registry 206) เพื่อหาค่าประเมินวลีเกี่ยวเนื่อง (Related Phrase Identifier 204) ที่จะถูกบันทึกร่วมกันเป็นข้อมูลความรู้
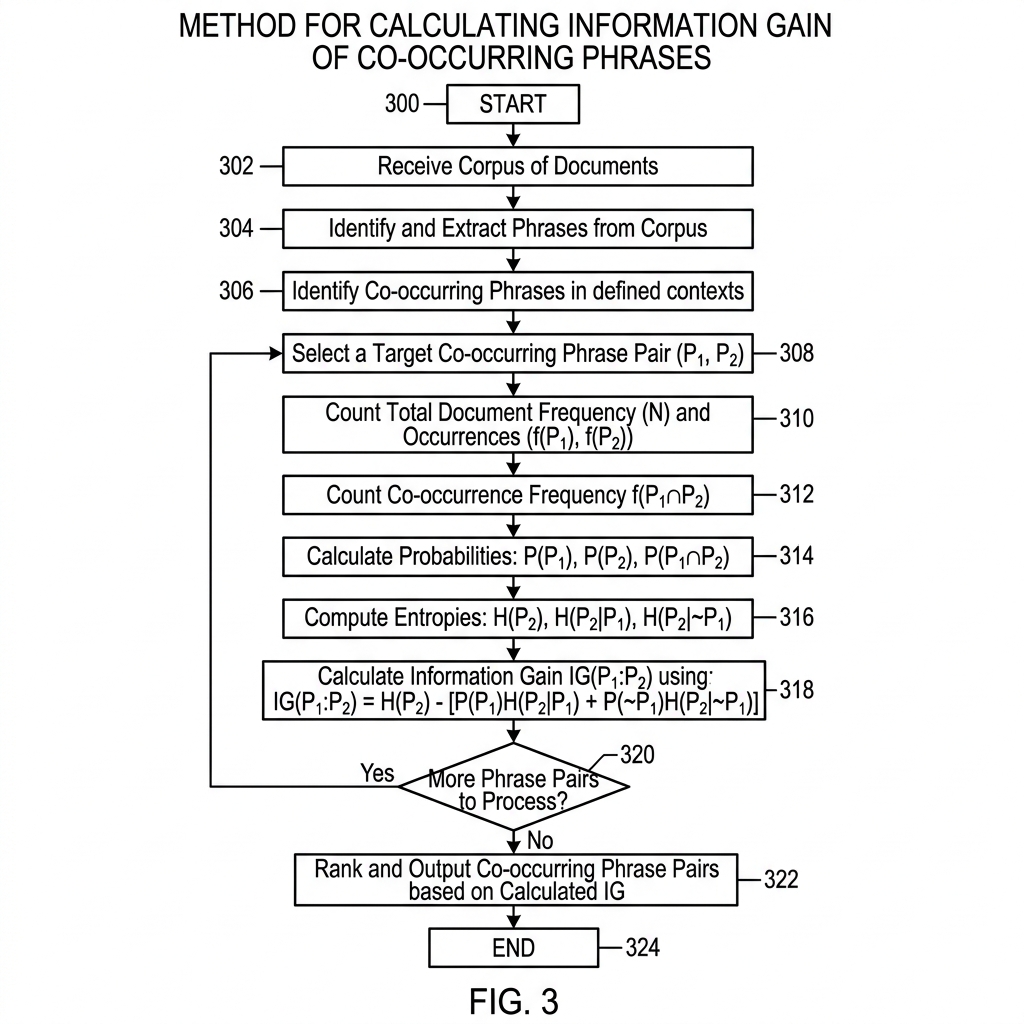
แผนผังอัลกอริทึมการประมวลผล เริ่มต้นจากการวิเคราะห์วลีผู้สมัคร (Candidate Phrases) -> มองหากลุ่มวลีที่ปรากฏตัวร่วมกัน -> นำมาคำนวณค่าปรากฏร่วมจริง A(j,k) และค่าคาดหวังทั่วไป E(j,k) -> ตรวจวัดค่า Information Gain (I) หากผ่านเกณฑ์ขั้นต่ำระบบจะบันทึกคีย์เวิร์ดร่วมนี้ในสารบัญดัชนีคุณภาพสูงทันที
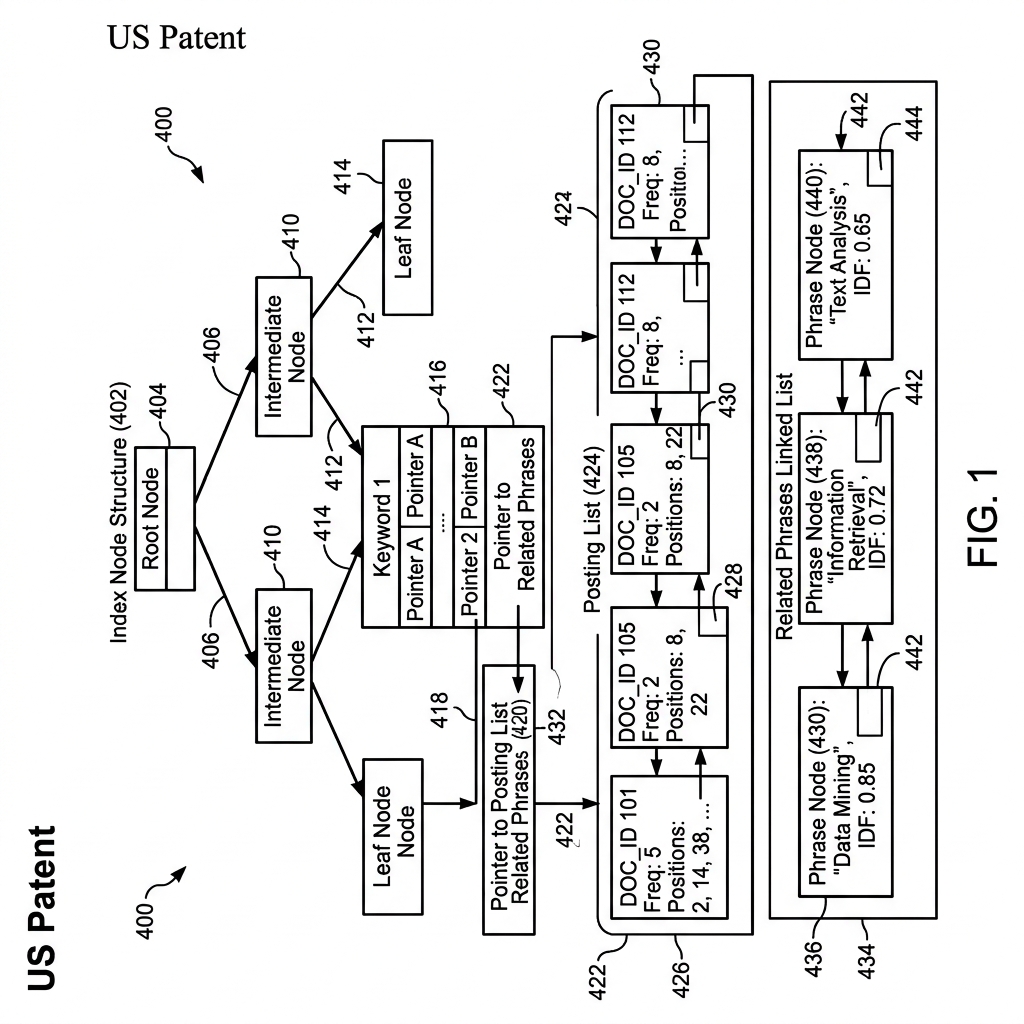
แสดงโครงสร้างข้อมูลในคอมพิวเตอร์ที่เก็บพิกัดของคำหลัก (Phrase Identifier 402) ร่วมกับลิงก์ข้อมูลของคำเกี่ยวเนื่อง (Related Phrase 404) ในลักษณะ Linked-List ซึ่งช่วยให้บ็อทกูเกิลประมวลความเกี่ยวโยงของแต่ละหน้าเพจได้อย่างรวดเร็วในเสี้ยววินาทีเมื่อมีการค้นหาข้อมูล
3. อิทธิพลของ Phrase-Based Indexing ต่อยุค AI Overviews และ GEO
ผลกระทบต่อ AI Search: ระบบ AI Search ยุคใหม่ (Google AI Overviews, Perplexity, SearchGPT) ประมวลผลภาษาด้วย Vector Embeddings และ RAG ซึ่งต่อยอดโดยตรงจากแนวคิด Phrase-Based Indexing การจัดโครงสร้างเนื้อหาด้วยเครือข่ายวลีที่มี Information Gain สูง จึงเป็นปัจจัยชี้ขาดในการถูกเลือกเป็นแหล่งข้อมูลอ้างอิงบน AI Summary
ในยุคที่ผู้ใช้งานหันมาถามคำถามเชิงลึกกับ AI เสิร์ชเอ็นจินไม่ได้มองหาหน้าเว็บที่มีคำตอบสั้นๆ แบบตื้นเขินอีกต่อไป แต่โมเดล AI จะมองหาเอกสารที่มี High Information Gain และครอบคลุมกลุ่มวลีเชิงบริบทที่ครบถ้วนสมบูรณ์
การปรับแต่งเว็บไซต์ในปัจจุบันจึงต้องยกระดับจากการทำ SEO แบบดั้งเดิมสู่ บริการที่ปรึกษา AI Search & GEO เพื่อวางโครงสร้าง Semantic Entity, ออกแบบ Contextual Hierarchy และเชื่อมโยงประเด็นที่ AI มองหา ช่วยให้แบรนด์ถูกดึงไปแสดงผลเป็นคำตอบอันดับหนึ่งในกล่อง AI Overview อย่างต่อเนื่อง
4. กลไกตรวจจับและลงโทษ Keyword Stuffing ด้วยโมเดลวลีสัมพันธ์
หนึ่งในประโยชน์หลักที่ Google ระบุไว้อย่างชัดเจนในสิทธิบัตร US 7,536,408 B2 คือการ ตรวจจับสแปม (Spam Detection)
- เนื้อหาสแปม (Spam/Keyword Stuffing): มีสัดส่วนของวลีเป้าหมายสูงผิดปกติ แต่ขาดแคลนวลีร่วมที่ควรจะมีตามธรรมชาติ (Zero Related Phrases) หรือนำคำที่ไม่เกี่ยวข้องกันมายำรวมกัน
- เนื้อหาคุณภาพสูง (Authoritative Content): มีอัตราการกระจายตัวของ Related Phrases อย่างสมดุล แสดงถึงความรู้ความเข้าใจจริงของผู้เขียนในหัวข้อนั้นๆ
เมื่อบ็อทสแกนพบว่าหน้าเว็บมีความถี่ของคีย์เวิร์ดหลักสูง แต่ Information Gain ของกลุ่มวลีรอบข้างเป็นศูนย์ อัลกอริทึมจะส่งสัญญาณเตือนไปยังระบบประเมินคุณภาพ เช่น Google Panda Quality Factor หรือระบบ Helpful Content เพื่อปรับลดอันดับทันที
5. กลยุทธ์การทำ Topical Authority & Semantic SEO ให้ชนะอัลกอริทึม
เพื่อนำทฤษฎี Phrase-Based Indexing มาปรับใช้จริงในธุรกิจของคุณ นี่คือ 3 แนวทางปฏิบัติที่พิสูจน์แล้วว่าสร้างผลลัพธ์ได้อย่างยั่งยืน:
1. ออกแบบ Semantic Topic Cluster อย่างเป็นระบบ
แทนที่จะเขียนบทความกระจัดกระจาย ให้วางโครงสร้างแบบ Pillar-Cluster โดยมีหน้าเสาหลัก (Pillar Page) ที่ครอบคลุมภาพรวม และมีบทย่อย (Cluster Content) ที่เจาะลึกกลุ่มวลีที่เกี่ยวข้องอย่างละเอียด เพื่อส่งเสริมคะแนน Topical Authority ร่วมกันทั้งโดเมน
2. เชื่อมโยง Internal Links ตาม Reasonable Surfer Model
การส่งผ่านค่า Authority ระหว่างกลุ่มวลีต้องอาศัยโครงสร้างลิงก์ภายในที่สมเหตุสมผล สามารถศึกษาเพิ่มเติมได้จาก สิทธิบัตร Reasonable Surfer Model เพื่อจัดวางลิงก์ภายในบทความในจุดที่ผู้อ่านมีโอกาสคลิกจริง
3. เสริมความแข็งแกร่งด้วย Structured Data และที่ปรึกษาผู้เชี่ยวชาญ
ช่วยให้บ็อทเข้าใจความสัมพันธ์ของ Entity ได้เร็วขึ้นผ่านการฝัง Schema Markup เชิงความหมาย และหากองค์กรของคุณต้องการวางแผนกลยุทธ์ SEO ระดับโครงสร้างพื้นฐาน การเลือกใช้ บริการที่ปรึกษา SEO มืออาชีพจะช่วยประหยัดเวลาและป้องกันข้อผิดพลาดที่อาจส่งผลกระทบต่อทราฟฟิกในระยะยาว
คำถามที่พบบ่อยเกี่ยวกับ Phrase-Based Indexing (FAQ)
Q: Phrase-Based Indexing คืออะไร และทำงานต่างจาก Traditional Indexing อย่างไร?
A: Phrase-Based Indexing คืออัลกอริทึมการจัดทำดัชนีของ Google ตามสิทธิบัตร US 7,536,408 B2 ที่ไม่ได้จัดเก็บเฉพาะคำเดี่ยว (Single Words) ตามความถี่ TF-IDF แต่จะตรวจจับและจัดกลุ่ม ‘วลีที่มีความสัมพันธ์ร่วมกัน’ (Co-occurrence & Related Phrases) เพื่อวัดความเชี่ยวชาญเฉพาะเรื่อง (Topical Authority) และแยกแยะเนื้อหาคุณภาพสูงออกจากสแปม
Q: ค่า Information Gain (I) ในสิทธิบัตร Phrase-Based Indexing คำนวณอย่างไร?
A: Information Gain ‘I’ คำนวณจากการเปรียบเทียบอัตราการปรากฏตัวร่วมจริงของคู่กลุ่มวลี A(j,k) กับอัตราการคาดหวังทั่วไป E(j,k) ในคลังเอกสาร หากกลุ่มวลีปรากฏคู่กันบ่อยกว่าความบังเอิญอย่างมีนัยสำคัญ ระบบจะบันทึกเข้าสู่ดัชนี Related Phrases เพื่อเป็นตัวบ่งชี้ความลึกของเนื้อหา
Q: Phrase-Based Indexing ตรวจจับ Keyword Stuffing ได้อย่างไร?
A: หน้าเว็บที่ทำ Keyword Stuffing มักยัดเยียดคีย์เวิร์ดหลักซ้ำๆ แต่ขาด ‘วลีแวดล้อมที่เกี่ยวเนื่อง’ (Related Phrases) ตามธรรมชาติ อัลกอริทึมจึงสามารถระบุได้ทันทีว่าเป็นเนื้อหาผิดธรรมชาติและลดทอนคะแนนการจัดอันดับลง
Q: การปรับแต่งเนื้อหาให้สอดคล้องกับ Phrase-Based Indexing ส่งผลดีต่อ AI Search และ GEO อย่างไร?
A: ระบบ AI Overviews, Perplexity และ Gemini ทำงานบนพื้นฐานของ Large Language Model ที่มองความสัมพันธ์เชิงความหมาย (Semantic Embeddings) การวางโครงสร้างเนื้อหาด้วยกลุ่มวลีที่ครอบคลุมจะทำให้ AI เข้าใจบริบทได้ชัดเจนและเลือกเนื้อหาไปสังเคราะห์เป็นคำตอบอ้างอิงบน AI Summary
เอกสารอ้างอิงทางวิชาการและสิทธิบัตร:
- US Patent 7,536,408 B2: “Phrase-based indexing in an information retrieval system” – Google LLC (Google Patents Link)
- สำรวจคลังสิทธิบัตรฉบับเต็มได้ที่ Google Search Patents Hub
